Spis treści
- Błąd 1 – mylenie SEO z GEO
- Błąd 2 – błędna konfiguracja robots.txt i blokowanie botów AI
- Błąd 3 – renderowanie po stronie klienta (CSR) jako niewidzialna ściana
- Błąd 4 – treść bez danych i bez autorytatywnych cytowań
- Błąd 5 – brak struktury semantycznej dostępnej dla botów
- Błąd 6 – brak pomiaru i niewidzialny ślepy punkt
Wiele firm nie ma żadnego narzędzia do mierzenia widoczności swojej marki w odpowiedziach AI – a mimo to ich zespoły aktywnie „optymalizują pod kątem LLM-ów”, kopiując reguły klasycznego SEO do zupełnie innego systemu. To prosta droga do niewidzialności. GEO (Generative Engine Optimization, czyli optymalizacja pod generatywne silniki wyszukiwania) rządzi się własną logiką: liczy się nie pozycja rankingowa, lecz to, czy Twoja treść trafia do syntezy, którą model buduje w czasie rzeczywistym. Poniżej opisuję błędy, które widzę najczęściej w audytach, wraz z konkretnymi krokami naprawczymi.
Błąd 1 – mylenie SEO z GEO
Tradycyjne SEO ocenia domeny przez pryzmat profilu linków i pozycji rankingowych. LLM-y (Large Language Models, czyli duże modele językowe) działają inaczej: analizują fragmenty tekstu, zamieniają je na reprezentacje wektorowe (tzw. osadzenia lub embeddingi – wielowymiarowe liczbowe reprezentacje znaczenia) i wyszukują te fragmenty, które semantycznie najlepiej odpowiadają na zadane pytanie. Wysoka pozycja w Google nie przekłada się automatycznie na cytowanie przez ChatGPT czy Perplexity.
Badanie Aggarwal et al. (KDD 2024) z Princeton University, przetestowane na benchmarku GEO-bench złożonym z 10 000 zapytań, pokazało wprost: strona z 5. pozycji w wynikach wyszukiwania, która zaczęła powoływać się na źródła, zwiększyła widoczność w odpowiedzi generatywnej o 115,1%, a ta sama metoda obniżyła widoczność strony z 1. pozycji o 30,3%. To fundamentalna zmiana reguł gry.
Cztery pary pojęć, które pomagają odróżnić obie dyscypliny:
- Słowa kluczowe vs reprezentacje wektorowe – SEO liczy wystąpienia frazy; LLM ocenia semantyczną bliskość całego fragmentu do zapytania.
- Pozycja rankingowa vs włączenie do syntezy – zamiast miejsca na liście liczy się to, czy Twój fragment trafił do wygenerowanej odpowiedzi.
- Profil linków vs wzorce cytowań – w GEO wiarygodność buduje się przez linkowanie do zewnętrznych badań, nie tylko przez pozyskiwanie backlinków.
- Ruch organiczny vs Share of Voice – wskaźnik cytowań (Citation Rate) i udział w dyskusji (Share of Voice, SoV) zastępują samą liczbę wizyt.
Upychanie słów kluczowych – wysiłek bez efektu
Upychanie słów kluczowych (keyword stuffing) to jedno z „osiągnięć” starego SEO, które w GEO nie pomaga. Kiedy tekst wielokrotnie powtarza tę samą frazę bez budowania relacji pojęciowych, fragment nie niesie dla modelu nowych informacji, które mógłby wykorzystać w odpowiedzi. Benchmark Princeton potwierdził to empirycznie: keyword stuffing dawał niewielką poprawę widoczności albo żadną – podobnie jak dosypywanie do tekstu unikalnych słów.
Zamiast tego: buduj treść wokół precyzyjnych faktów, dat, liczb i relacji przyczynowo-skutkowych. Każdy zwarty fragment powinien samodzielnie odpowiadać na jedno konkretne pytanie – bez konieczności czytania reszty artykułu.
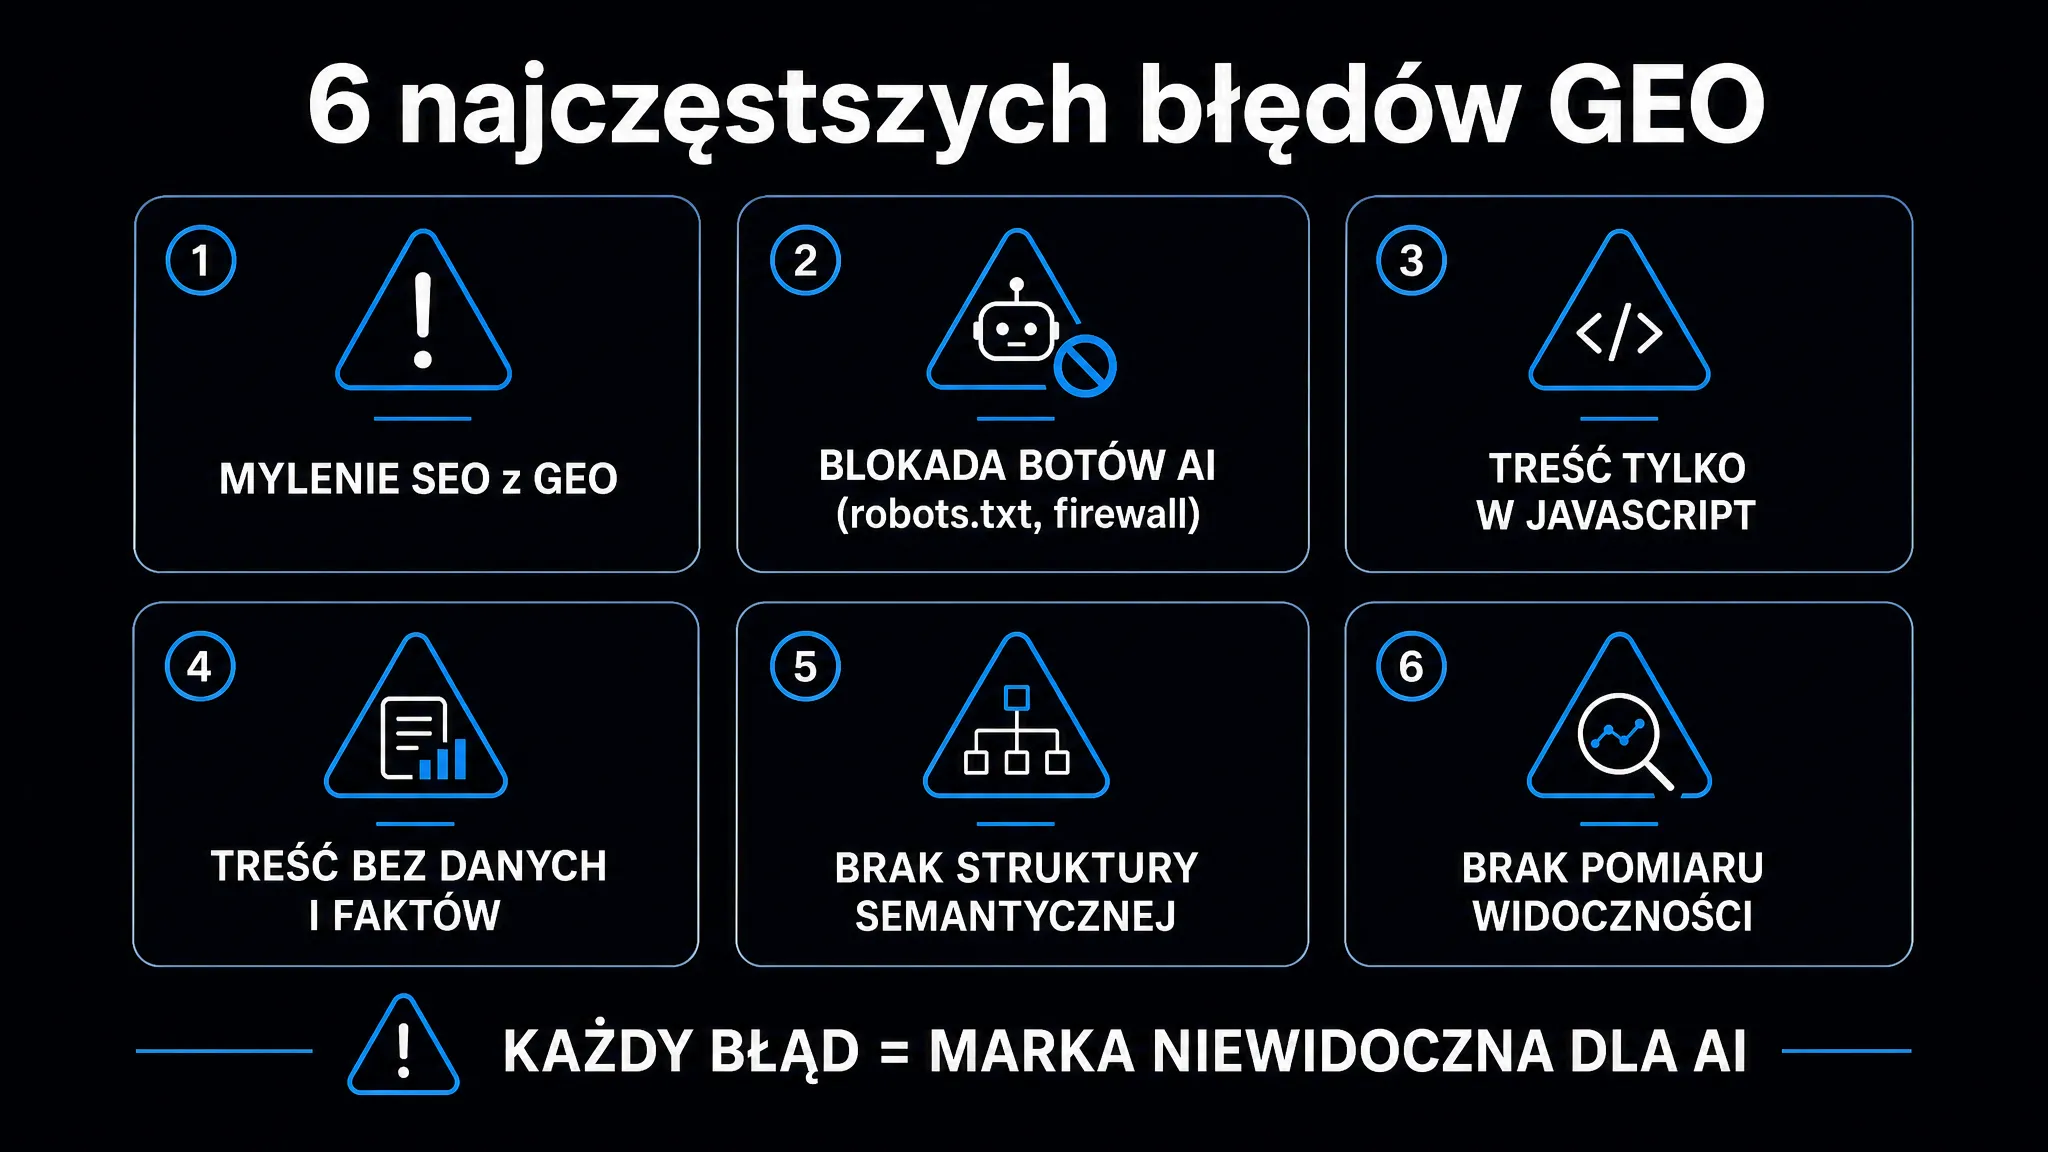
Błąd 2 – błędna konfiguracja robots.txt i blokowanie botów AI
Problematyczne konfiguracje pliku robots.txt to częsty wynik technicznych audytów GEO. Typowy scenariusz: administrator, przestraszony doniesieniami o masowym pobieraniu treści przez systemy AI, blokuje wszystkich agentów zawierających w nazwie słowo „Bot” lub „AI”. Skutek jest odwrotny od zamierzonego – witryna znika z odpowiedzi ChatGPT Search czy Perplexity.
Boty AI dzielą się na dwie zasadniczo różne klasy, które wymagają odmiennej polityki dostępu:
| Klasa bota | Przykłady | Rola | Zalecana polityka |
|---|---|---|---|
| Boty wyszukiwawcze i użytkownika | OAI-SearchBot, PerplexityBot, ChatGPT-User, Claude-SearchBot | Pobieranie treści w czasie rzeczywistym, prezentacja odpowiedzi z linkiem do Twojej strony | Allow – blokada = zero ruchu referencyjnego |
| Boty treningowe i tokeny kontrolne | GPTBot, ClaudeBot, CCBot, Google-Extended (token w robots.txt, nie osobny crawler) | Pobieranie zasobów do trenowania modeli; w przypadku Google-Extended – zgoda na użycie treści do trenowania i ugruntowania modeli Gemini | Disallow – wysokie zużycie transferu, brak bezpośredniego ruchu |
Zablokowanie OAI-SearchBot eliminuje Cię z wyników ChatGPT Search. Zablokowanie PerplexityBot – z Perplexity AI. Z kolei zablokowanie Google-Extended nie wpływa na obecność w wyszukiwarce Google, w tym w AI Overviews. Obie te pomyłki często nie są widoczne w standardowych raportach analitycznych, bo nie generują błędów 4xx na poziomie serwera. Sprawdź, czy Twoje boty mają dostęp, korzystając z narzędzia Dostęp botów AI – weryfikuje ono konfigurację robots.txt i faktyczną dostępność dla poszczególnych agentów.
Nowa pułapka pojawiła się 31 sierpnia 2026 roku: przełącznik Search generative AI control w Google Search Console. Jego wyłączenie usuwa stronę z AI Overviews, AI Mode i funkcji AI w Discover, choć zwykłe wyniki zostają bez zmian – i, podobnie jak blokada bota, nie generuje żadnych błędów po stronie serwera. Sprawdź to ustawienie podczas audytu.
Cloudflare i niewidzialna blokada na brzegu sieci
Osobna pułapka czeka na strony hostowane za sieciami dostarczania treści (CDN), szczególnie za Cloudflare. Ustawienie „Block AI bots” po aktywowaniu blokuje crawlery treningowe AI bezpośrednio na brzegu sieci – zanim bot w ogóle dotrze do serwera i przeczyta plik robots.txt. Samo w sobie nie obejmuje botów wyszukiwawczych, ale 15 września 2026 roku Cloudflare zastąpił je osobnymi ustawieniami dla trzech kategorii: Training, Agent i Search. Każdą można zablokować na wszystkich stronach, tylko na stronach z reklamami albo dopuścić. Dla nowych domen domyślnie blokowane są boty Training i Agent na stronach z reklamami, a Search pozostaje dozwolony – sprawdź więc, czy blokada agentów nie odcina pobierania stron na żądanie użytkowników ChatGPT czy Perplexity. Twoja poprawnie skonfigurowana reguła robots.txt staje się wówczas nieistotna – zablokowany bot nigdy jej nie zobaczy.
Weryfikacja wymaga ręcznego sprawdzenia nagłówków odpowiedzi CDN dla znanych user-agentów botów, a nie samego pliku konfiguracyjnego.
Błąd 3 – renderowanie po stronie klienta (CSR) jako niewidzialna ściana
Większość botów AI używanych w systemach generowania wspomaganego wyszukiwaniem (RAG – Retrieval-Augmented Generation) pobiera wyłącznie surowy kod HTML zwrócony przez serwer i nie uruchamia interpretera JavaScript. Jeśli Twoja witryna opiera się na renderowaniu po stronie klienta (Client-Side Rendering, CSR) – gdzie kluczowe tabele porównawcze, opisy produktów czy cenniki ładują się dynamicznie po uruchomieniu skryptów – bot AI zobaczy pusty szablon HTML bez żadnej treści merytorycznej.
Informacje schowane za interakcjami użytkownika – rozwijane akordeony, zakładki wymagające kliknięcia, kalkulatory, ekrany logowania – są dla botów AI całkowicie niedostępne. Jeśli chcesz, żeby dana treść była cytowana, musi być w pełni widoczna w kodzie HTML zaraz po załadowaniu strony, bez symulowania zdarzeń przeglądarkowych.
Wymagany standard techniczny to renderowanie po stronie serwera (SSR) lub generowanie statyczne (SSG). Coraz więcej platform CMS oferuje te tryby domyślnie lub jako przełączalną opcję – warto zweryfikować, jak skonfigurowana jest Twoja witryna, zanim zaczniesz optymalizować treść.
Błąd 4 – treść bez danych i bez autorytatywnych cytowań
To najczęstszy błąd treściowy, który widzę w audytach. Strona ma dobre pozycje SEO, solidny profil linków, przyzwoity ruch – ale treść wygląda jak napisana pod algorytm Google’a sprzed 2020 roku: ogólnikowe opisy, zero liczb, zero dat, każde twierdzenie to opinia bez podstawy źródłowej.
Dla modelu językowego taka strona jest bezużyteczna jako źródło cytowania. Modele są trenowane, żeby treści opatrzone przypisami do zewnętrznych źródeł traktować jako bardziej wiarygodne. Badanie Princeton zmierzyło to precyzyjnie: powoływanie się na źródła podnosiło widoczność w odpowiedziach generatywnych o ok. 27,7%, a dodanie danych liczbowych o ok. 32,8%. Autorytatywny ton dawał wzrost rzędu 11,8%.
Trzy praktyczne działania, które możesz wdrożyć w ciągu jednego dnia roboczego:
- Dane liczbowe z datą i źródłem – zamiast „rynek rośnie” napisz „rynek rośnie o 23% rok do roku (Gartner 2025)”; liczby są łatwiejsze do wyekstrahowania przez parsery wektorowe niż narracyjne opisy.
- Cytowania ekspertów lub badań – każda sekcja H2 powinna zawierać przynajmniej jedno twierdzenie z nazwanym źródłem; nie musisz linkować do każdego – wystarczy wymienić nazwę badania i rok.
- Unikanie dwuznaczności encji – zamiast „ostatniej aktualizacji algorytmu” napisz „Google March 2024 Core Update”; precyzyjne nazwy własne umożliwiają modelowi poprawne odwzorowanie pojęcia w grafach wiedzy.
Artykuł Jak LLM-y cytują źródła tłumaczy mechanizm selekcji fragmentów do cytowania – warto przeczytać go przed przepisywaniem priorytetowych podstron.
Błąd 5 – brak struktury semantycznej dostępnej dla botów
LLM-y nie czytają strony jak człowiek – systemy RAG dzielą tekst na fragmenty (ich długość zależy od systemu), konwertują je na reprezentacje wektorowe i wyszukują te, które pasują do danego podzapytania. Tekst pisany jako jeden długi ciągły blok narracyjny utrudnia ten podział i drastycznie obniża szanse na wybranie konkretnego fragmentu.
Dobre wzorce strukturyzacji treści pod GEO:
- Nagłówki jako pytania – H2 i H3 sformułowane jak zapytanie użytkownika, a bezpośrednio pod nimi odpowiedź w pierwszym zdaniu (zasada wczesnego sygnalizowania kluczowych informacji).
- Tabele porównawcze – model może wyciągnąć pojedynczy wiersz tabeli jako samodzielną, precyzyjną odpowiedź; szczególnie skuteczne dla cenników i zestawień narzędzi.
- Listy z definicjami – format
**Termin** – opistworzy naturalną parę pojęcie-wyjaśnienie, którą parsery wektorowe łatwo ekstrahują. - Bloki semantyczne – każdy fragment (w praktyce redakcyjnej zwykle 200–400 słów) powinien zawierać definicję, tezę lub dane bez konieczności czytania reszty artykułu; samodzielność to klucz.
Kluczowe informacje poza zasięgiem botów – PDF-y i obrazy z danymi
Publikowanie ważnych danych wyłącznie w plikach PDF lub jako grafiki bez tekstu alternatywnego to kolejna techniczna bariera. PDF nie ma czytelnej struktury semantycznej HTML (hierarchii nagłówków, tagów sekcji), co drastycznie obniża precyzję wyekstrahowanych danych. Dane w obrazach bez atrybutu alt są dla botów AI niewidoczne – model nie potrafi ich odczytać.
Standardem minimum jest czysta hierarchia HTML: tagi <article>, <section>, nagłówki od H1 do H3, dane strukturalne JSON-LD. Szczegółowy przewodnik po implementacji danych strukturalnych obejmuje artykuł o schema.org i danych strukturalnych – z przykładami dla różnych typów stron.
Błąd 6 – brak pomiaru i niewidzialny ślepy punkt
Ostatni błąd jest paradoksalnie najpoważniejszy: wiele organizacji w ogóle nie mierzy swojej widoczności w odpowiedziach AI. Bez tego wskaźnika każda optymalizacja to strzelanie w ciemno.
Trzy metryki, od których warto zacząć monitoring:
- Citation Rate (wskaźnik cytowań) – procent zapytań z zestawu testowego, w których odpowiedź AI zawiera Twoją markę lub URL; obliczysz go ręcznie, odpytując 20–30 zapytań co dwa tygodnie.
- Share of Voice (SoV, udział w dyskusji) – jaki procent cytowań w danej niszy trafia do Twojej marki, a jaki do konkurentów; wymagana regularna analiza zestawu 20–50 zapytań.
- Mention Rate (wskaźnik wzmianek) – ile razy marka pojawia się w odpowiedziach bez linka; ważny dla budowania rozpoznawalności w LLM-ach.
Praktyczny punkt startowy: wybierz 20 pytań, które Twoi klienci wpisują w ChatGPT lub Perplexity. Odpytuj je co dwa tygodnie w czystej sesji przeglądarki bez personalizacji. To Twój bazowy wskaźnik cytowań przed wdrożeniem jakichkolwiek zmian. Pełny przewodnik po GEO opisuje metodologię pomiaru i 6-miesięczny horyzont wdrożenia.
Jeśli chcesz zobaczyć punkt startowy szybciej, narzędzie Ocena cytowalności strony analizuje Twoją stronę pod kątem cytowalności i wskazuje konkretne elementy do poprawy – bez konieczności manualnego testowania.
FAQ
Czy blokowanie GPTBot wyklucza mnie z wyników ChatGPT?
GPTBot (bota treningowego) to co innego niż blokowanie OAI-SearchBot (bota wyszukiwawczego). GPTBot zbiera dane do trenowania modeli offline. OAI-SearchBot pobiera treści w czasie rzeczywistym, żeby ChatGPT Search mógł cytować Twoją stronę użytkownikom. Możesz bezpiecznie blokować GPTBot, jednocześnie zezwalając na OAI-SearchBot – i to jest zalecana konfiguracja dla większości wydawców.Jak szybko widać efekty po poprawieniu treści?
PerplexityBot) mają krótsze cykle indeksowania niż Googlebot – tygodniowe lub nawet codzienne. Efekty związane z danymi treningowymi (modele offline) pojawiają się dopiero po aktualizacji modeli, co może zająć kilka miesięcy.Co ważniejsze – techniczne fundamenty czy treść?
robots.txt blokuje boty wyszukiwawcze, najlepsza treść i tak nie zostanie zacytowana – napraw technikę najpierw. Jeśli strona jest technicznie dostępna, ale treść to ogólnikowe opisy bez danych, bot wejdzie, pobierze fragmenty i nie wybierze ich przy generowaniu odpowiedzi. Obie warstwy muszą działać jednocześnie.Czy GEO ma sens dla małych firm z niskim autorytetem domeny (DA)?
Źródła
- GEO: Generative Engine Optimization – Aggarwal i in., KDD 2024. GEO-bench (10 000 zapytań z 25 dziedzin), 9 testowanych metod, słaby wynik keyword stuffingu i wzrosty dla cytatów, statystyk i powoływania się na źródła.
- Overview of OpenAI Crawlers – OpenAI. Role OAI-SearchBot, GPTBot i ChatGPT-User; ustawienia dla każdego bota są niezależne, więc można blokować GPTBot i dopuszczać OAI-SearchBot.
- Perplexity Crawlers – Perplexity. PerplexityBot służy do wyświetlania i linkowania stron w wynikach Perplexity, a nie do trenowania modeli.
- List of Google’s common crawlers – Google Search Central. Google-Extended kontroluje wykorzystanie treści do trenowania i ugruntowania modeli Gemini i nie wpływa na obecność w wyszukiwarce Google.
- Search generative AI control – Pomoc Google Search Console. Przełącznik wyłączający witrynę z AI Overviews, AI Mode i funkcji AI w Discover; globalnie od 31 sierpnia 2026 roku.
- Block AI Bots – Cloudflare. Ustawienie blokujące w całej strefie boty klasyfikowane jako crawlery treningowe AI (bez botów mieszanych, służących też wyszukiwaniu); wycofane 15 września 2026 roku na rzecz osobnych ustawień dla botów treningowych, agentów i wyszukiwarek; dla nowych domen boty Training i Agent są domyślnie blokowane na stronach z reklamami.
- Retrieval-augmented generation – Wikipedia. Definicja generowania wspomaganego wyszukiwaniem (RAG).