Spis treści
ChatGPT to interfejs konwersacyjny zbudowany na modelach z rodziny GPT (Generative Pre-trained Transformer) – dużych modelach językowych (LLM, Large Language Model) opracowanych przez OpenAI. Od publicznego debiutu w listopadzie 2022 roku zgromadził milion użytkowników w pięć dni. Sto milionów osiągnął w dwa miesiące. Zrobił to szybciej niż jakakolwiek inna aplikacja w historii. Jeśli dopiero zaczynasz pracę z AI lub chcesz wreszcie zrozumieć, co kryje się za tym oknem czatu, ten przewodnik wyjaśnia mechanizm, możliwości i realne ograniczenia. Bez skrótów. Bez żargonu, który więcej ukrywa, niż tłumaczy.
Czym jest ChatGPT i jak wpisuje się w ekosystem OpenAI?
OpenAI to laboratorium badań nad sztuczną inteligencją założone w 2015 roku z misją rozwoju AI dla dobra ogółu. ChatGPT nie jest jedynym produktem firmy – to raczej najbardziej widoczna warstwa potężnego ekosystemu. Obejmuje on modele, interfejsy programistyczne i wyspecjalizowane narzędzia.
Uporządkujmy te pojęcia na samym wstępie:
- GPT – seria modeli językowych (GPT-3, GPT-4, rodzina GPT-5 – od lipca 2026 w ChatGPT flagowa generacja to GPT-5.6 w trzech wariantach: Sol, Terra i Luna – a od września 2026 roku generacja GPT-6: najmocniejszy GPT-6 Astra (w API i w ChatGPT jako GPT-6 Pro) oraz GPT-6 Sol, GPT-6.1 Sol i GPT-6 Luna (w API, ChatGPT Work i Codex)); sam model to „silnik”, który przetwarza tekst
- ChatGPT – produkt konsumencki, interfejs czatu dostępny pod adresem chatgpt.com, napędzany aktualnym modelem GPT
- OpenAI API – programistyczny dostęp do modeli GPT, modeli obrazowych i innych, używany przez deweloperów do budowy własnych aplikacji
- ChatGPT Images – generowanie obrazów z opisu tekstowego wbudowane w ChatGPT (DALL-E zastąpiono w marcu 2025 roku, a od kwietnia 2026 roku działa model ChatGPT Images 2.0)
- Whisper – model do transkrypcji i tłumaczenia mowy
ChatGPT działa w przeglądarce i aplikacji mobilnej, a od 2023 roku również jako wtyczka i element Microsoft 365 Copilot. OpenAI udostępnia swoje modele przez API, co pozwala firmom zewnętrznym wbudowywać je we własne produkty. Właśnie dlatego technologia ta pojawia się pośrednio w Bingu, narzędziach do pisania, systemach obsługi klienta i dziesiątkach innych miejsc.
W kontekście widoczności marki w wyszukiwarkach AI: pełny obraz tego, co GPT „wie” o Twojej firmie i skąd czerpie tę wiedzę, opisuje przewodnik po modelach LLM. To doskonały punkt wyjścia przed startem optymalizacji.
Jak działa model GPT, od tokenów po odpowiedź?
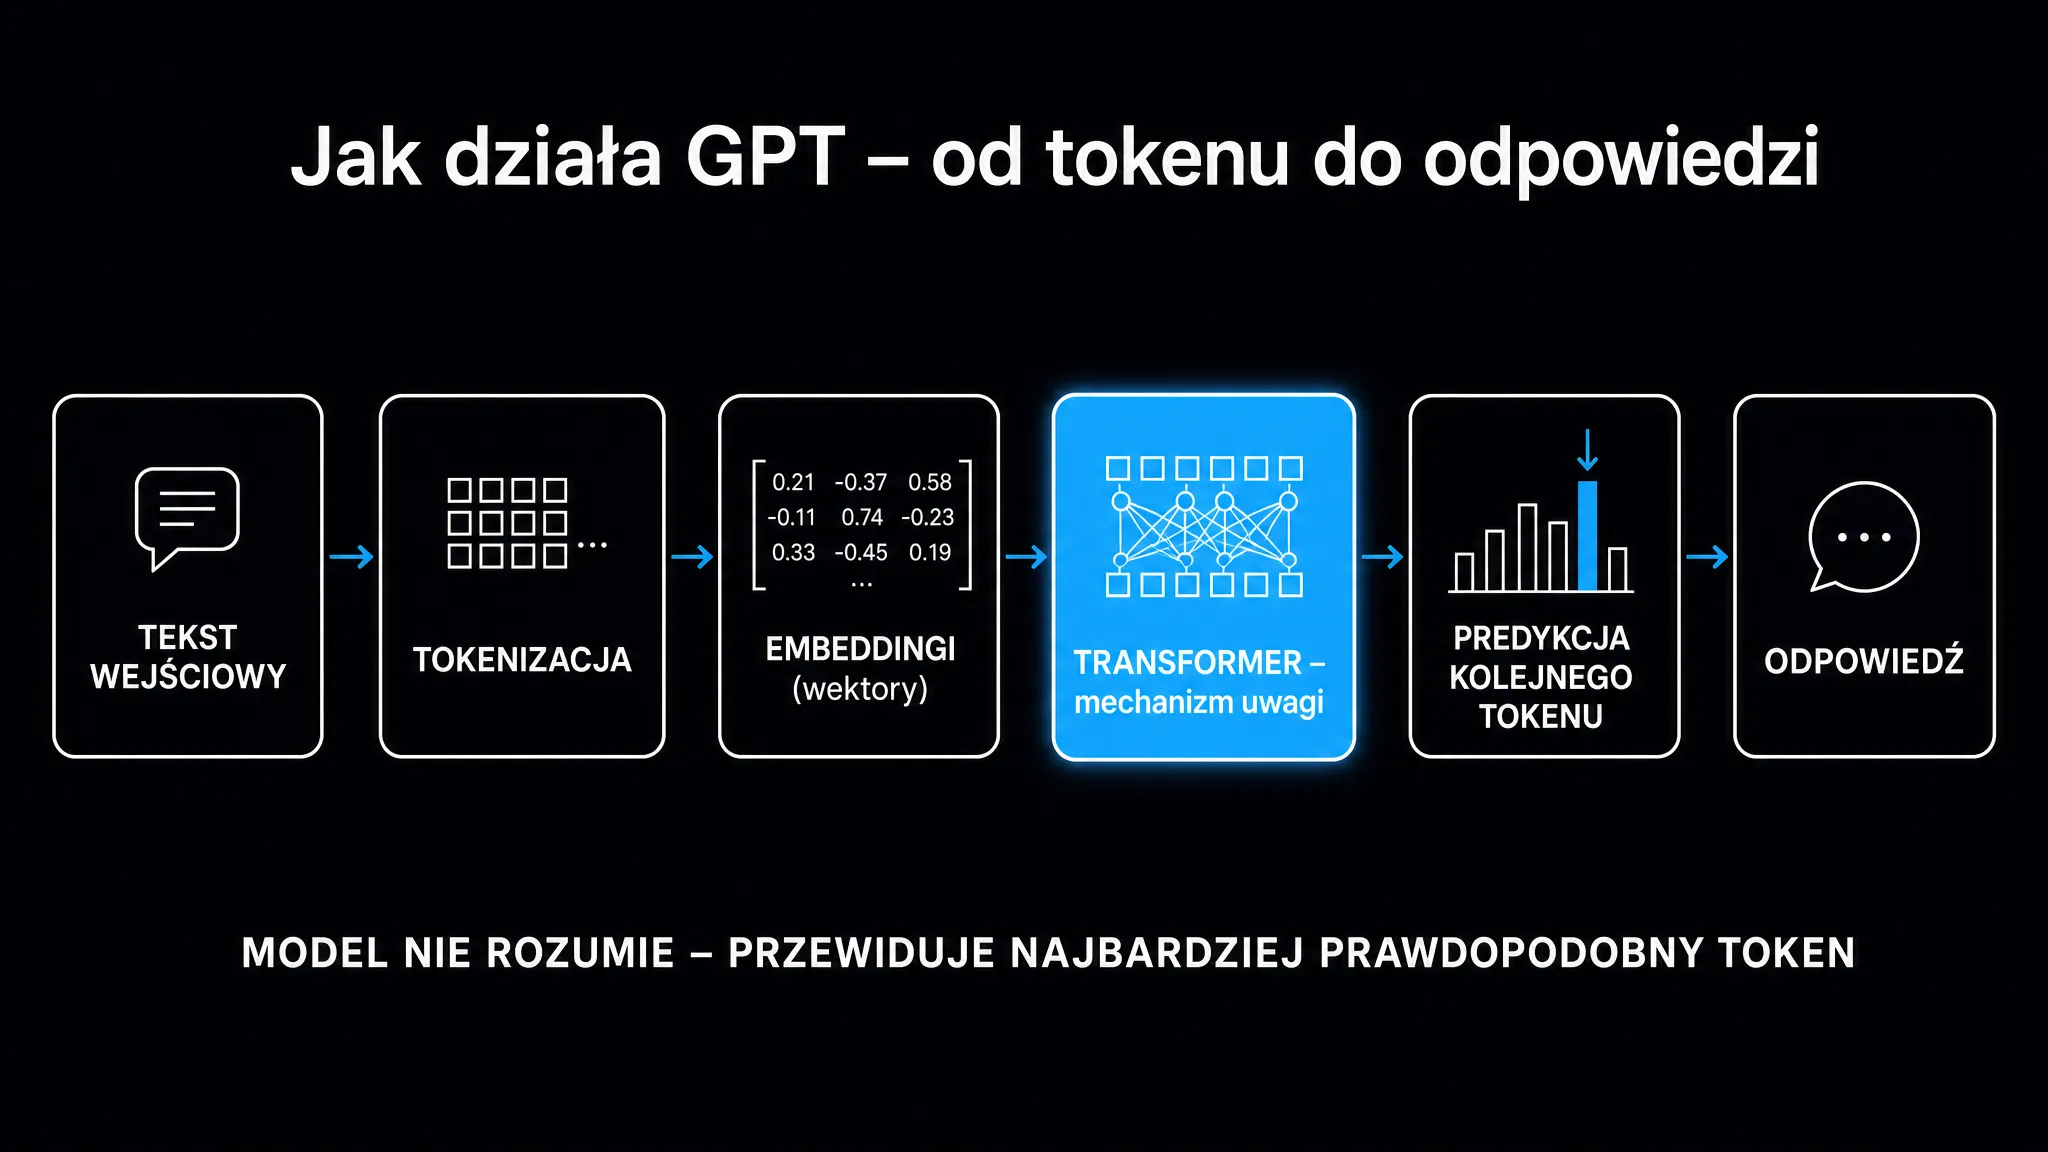
ChatGPT nie „szuka” odpowiedzi w bazie danych ani nie „pamięta” faktów jak encyklopedia. Generuje tekst token po tokenie. Za każdym razem przewiduje, jaka sekwencja znaków jest najbardziej prawdopodobna w danym kontekście. To subtelna, ale fundamentalna różnica.
Model opiera się na architekturze typu Transformer – typie sieci neuronowej zaprezentowanym w pracy „Attention is All You Need” (Vaswani et al., 2017). Wcześniejsze systemy przetwarzały tekst sekwencyjnie, czyli słowo po słowie. Transformer analizuje wszystkie tokeny wejścia równolegle. Oblicza dla każdego z nich wagi mechanizmu uwagi względem pozostałych elementów. Dzięki temu potrafi śledzić relacje między słowami oddalonymi o setki pozycji w tekście.
Tokenizacja i kontekst
Zanim model przetworzy zdanie, dzieli je na tokeny – podjednostki leksykalne mniejsze niż słowo (np. „pozycjonowanie” może być jednym lub kilkoma tokenami, zależnie od tokenizera). Flagowe modele z rodziny GPT-5 operują na oknie kontekstowym przekraczającym milion tokenów (wcześniejsze generacje GPT-4 były ograniczone do 128 000 tokenów). Milion tokenów to z grubsza obszerne repozytorium kodu albo kilka książek naraz. Oznacza to, że model „widzi” całą bieżącą rozmowę jednocześnie, bez konieczności „przypominania sobie” poprzednich kroków.
Każdy token jest zamieniany na wektor liczbowy w wielowymiarowej przestrzeni. Mechanizm uwagi (ang. attention mechanism) oblicza dla każdej pary tokenów stopień ich semantycznej zależności. Wynik to nie lista faktów, lecz matematyczna reprezentacja relacji między pojęciami. Właśnie dlatego model potrafi odpowiadać na pytania, których nigdy dosłownie nie widział w danych treningowych.
W uproszczeniu: kiedy piszesz „Jakie są zalety pracy zdalnej?”, model nie sięga po gotową odpowiedź. Rozkłada zapytanie na tokeny. Oblicza ich relacje ze wszystkimi kontekstami, jakie widział podczas treningu, a następnie generuje odpowiedź jako ciąg znaków o najwyższym łącznym prawdopodobieństwie. Każde słowo wpływa na prawdopodobieństwo kolejnego. To dlatego modele są nieprzewidywalne przy powtórzeniu tego samego pytania. Losowość jest wbudowana w sam mechanizm (parametr temperatury, ang. temperature, kontroluje, jak bardzo model „eksperymentuje” z rzadszymi tokenami).
Trening i dostosowanie do rozmowy
Sam etap wstępnego trenowania (pre-training) na terabajtach tekstu z internetu, książek i kodu tworzy potężny silnik predykcyjny. Generuje on równie sprawnie treści pomocne, co szkodliwe. OpenAI stosuje metodę RLHF (Reinforcement Learning from Human Feedback, czyli uczenie ze wzmocnieniem na podstawie ludzkich ocen), żeby ukierunkować model na dostarczanie użytecznych i bezpiecznych odpowiedzi.
Proces RLHF przebiega w trzech krokach. Po pierwsze, anotatorzy piszą przykładowe idealne odpowiedzi – model uczy się wzorca. Po drugie, ten sam model generuje kilka wariantów odpowiedzi na jedno pytanie, a ludzie szeregują je od najlepszej do najgorszej. Na tej podstawie trenowany jest oddzielny model oceniający (reward model). Po trzecie, algorytm PPO (Proximal Policy Optimization) aktualizuje wagi modelu tak, żeby maksymalizował oceny modelu nagradzającego, jednocześnie nie odchodząc za daleko od wyjściowego rozkładu probabilistycznego.
Efekt? Model nie tylko przewiduje prawdopodobny tekst, ale robi to w sposób, który ludzie oceniają jako pomocny i bezpieczny.
Plany i możliwości – co oferuje każda wersja
ChatGPT jest dostępny w kilku planach subskrypcyjnych. Zestawienie kluczowych różnic i limitów (stan na wrzesień 2026) ułatwia wybór odpowiedniej wersji:
| Plan | Cena | Dostęp do modeli | Kluczowe funkcje |
|---|---|---|---|
| Free | 0 USD/mies. | GPT-5.6 Luna (GPT-6 Luna w aplikacji desktopowej) | Czat tekstowy na Luna, limitowane generowanie obrazów, pliki i Deep Research; w niektórych krajach z reklamami |
| Go | 8 USD/mies. | GPT-5.6 Luna (GPT-6 Luna w aplikacji desktopowej) | Plan dla codziennych użytkowników, wyższe limity niż Free |
| Plus | 20 USD/mies. | GPT-5.6 Sol, Terra i Luna; GPT-6 Sol i Luna w ChatGPT Work i Codex; ChatGPT Images 2.0 | Wyższe limity, Deep Research, Codex, okno 54 tys. / 256 tys. tokenów (Instant / rozumowanie) |
| Business | 20 USD/os./mies. rocznie (25 USD miesięcznie), min. 2 osoby | Konfigurowalne; m.in. GPT-6 Pro (Astra), GPT-6 Sol i Luna | Przestrzeń zespołowa, izolacja danych od trenowania |
| Pro | 100, 200 lub 500 USD/mies. | GPT-6 Pro (GPT-6 Astra; w wariancie 500 USD także tryb Ultrafast), GPT-5.6 Sol Pro, GPT-6 Sol i Luna w Work i Codex | 5×, 20× (od 30 października 2026 – 10×) lub 25× wyższe limity niż Plus, okno 128 tys. / 400 tys. tokenów |
| Enterprise | Negocjowane | Konfigurowalne, w tym GPT-6 Pro | SOC 2 Type II, SSO, niestandardowe retencje danych |
Plan Free wystarczy do testowania i zadań sporadycznych. Do regularnej pracy – szczególnie gdy liczy się jakość i wyższe limity w dostępie do asystentów AI (tzw. copilotów) – Plus pozostaje standardowym wyborem. Daje dostęp do flagowego GPT-5.6 Sol – rodzina GPT-5.6 trafiła do ogólnej dostępności 9 lipca 2026 roku (Sol nie jest dostępny w planach Free i Go). Plany Pro (warianty 100, 200 i – od 29 września 2026 – 500 USD z trybem Ultrafast, czyli szybszym generowaniem odpowiedzi przez GPT-6 Astra) celują w zaawansowanych profesjonalistów i programistów. Dają odpowiednio 5×, 20× i 25× wyższe limity niż Plus (wariant za 200 USD od 30 października 2026 – 10×), rozszerzają okno kontekstowe w czacie do 400 tysięcy tokenów i odblokowują GPT-6 Pro (napędzany GPT-6 Astra) oraz GPT-5.6 Sol Pro z najwyższym budżetem wnioskowania.
Najmocniejszy model OpenAI – GPT-6 Astra – zadebiutował 3 września 2026 roku (okno 1,05 mln tokenów, do 128 tys. tokenów wyjścia, data odcięcia wiedzy 30 kwietnia 2026, w API 10 USD za milion tokenów wejściowych i 50 USD za wyjściowe). W ChatGPT działa jako GPT-6 Pro w planach Pro, Business i Enterprise. 22 września dołączyły GPT-6 Sol (2/10 USD) i GPT-6 Luna (0,10/0,50 USD), a 29 września – GPT-6.1 Sol (również 2/10 USD, z tańszym cache – 0,10 USD), który według OpenAI w kodowaniu agentowym zbliża się do Astry – wszystkie w API oraz w ChatGPT Work i Codex dla planów Plus i wyższych. Domyślny czat nadal działa na GPT-5.6.
Do czego używać ChatGPT – zastosowania w praktyce
Użytkownicy nierzadko traktują ChatGPT jako klasyczną wyszukiwarkę. To błąd. Prowadzi do rozczarowań i ryzykownych decyzji biznesowych. ChatGPT sprawdza się tam, gdzie zadanie wymaga przetwarzania i transformacji tekstu, a nie tam, gdzie potrzebne są sprawdzone, bieżące fakty.
Obszary, w których model działa niezawodnie:
- Pisanie i redakcja – przeredagowanie tekstu, zmiana tonu, skracanie, tłumaczenie, korekta stylistyczna
- Programowanie – pisanie, debugowanie i tłumaczenie kodu; szczególnie mocne w popularnych językach (Python, JavaScript, SQL)
- Analiza dokumentów – wgranie pliku PDF lub arkusza i zadanie pytań o treść; ekstrakcja tabel, zestawień, kluczowych tez
- Burza mózgów – generowanie wariantów pomysłów, nazw, struktur artykułów, szkiców prezentacji
- Nauka – tłumaczenie skomplikowanych pojęć na prostszy język, generowanie przykładów, tworzenie fiszek
Obszary, w których należy zachować ostrożność:
- Fakty i aktualne dane – model ma datę odcięcia (cutoff date) i nie zna wydarzeń po niej; nawet przed datą odcięcia może „halucynować”, czyli generować w przekonujący sposób informacje nieprawdziwe
- Porady prawne, medyczne, finansowe – użyteczne jako wstępny zarys, nie jako substytut specjalisty
- Cytowania naukowe – model może wygenerować bibliografię, która wygląda wiarygodnie, ale w rzeczywistości nie istnieje
Granice możliwości tego narzędzia opisuje szczegółowo artykuł co potrafi ChatGPT, w którym znajdziesz praktyczne testy przypadków brzegowych.
Halucynacje – największe ograniczenie modelu
Halucynacja to sytuacja, w której model generuje odpowiedź syntaktycznie poprawną i sformułowaną w przekonujący sposób, ale merytorycznie błędną lub całkowicie wymyśloną. Termin ten wywodzi się z samej natury generowania. Model nie szuka faktów – przewiduje prawdopodobny ciąg tokenów. Jeśli kontekst skieruje go w stronę rzadkiego obszaru przestrzeni wag, wygeneruje coś, co brzmi jak fakt, choć wcale nim nie jest.
Halucynacje są szczególnie niebezpieczne, kiedy model podaje konkretne daty, nazwiska, tytuły publikacji lub ceny z absolutną pewnością. Oto kilka praktycznych reguł zmniejszających to ryzyko:
- Zawsze podawaj kontekst w pytaniu – im bardziej precyzyjne zapytanie, tym mniejsza swoboda modelu
- Weryfikuj liczby i cytowania zewnętrznie – każde twierdzenie z liczbą sprawdź w niezależnym źródle przed użyciem
- Wgrywaj dokumenty zamiast prosić o wiedzę z pamięci – model operujący na wgranym pliku halucynuje znacznie rzadziej niż odpowiadający z danych treningowych
- Stosuj technikę chain-of-thought – poproś model, żeby „myślał głośno” krok po kroku; przekierowanie uwagi na rozumowanie redukuje błędy faktyczne
Generowanie wspomagane wyszukiwaniem (RAG – Retrieval-Augmented Generation) to architektoniczne rozwiązanie tego problemu stosowane przez Perplexity i Google AI Overviews. Zamiast polegać wyłącznie na danych treningowych, model dynamicznie pobiera fragmenty stron i dopiero na ich podstawie generuje odpowiedź. ChatGPT z włączoną opcją wyszukiwania działa podobnie, choć sam mechanizm jest wewnętrznie inny.
ChatGPT a pozycjonowanie Twojej marki w AI
Rosnąca liczba użytkowników, którzy zamiast Google wpisują pytania bezpośrednio w ChatGPT, tworzy zupełnie nową kategorię widoczności. Gartner prognozował w 2024 roku, że do 2026 roku wolumen zapytań w tradycyjnych wyszukiwarkach spadnie o 25% na rzecz chatbotów i wirtualnych agentów AI.
Jeśli potencjalny klient pyta „Które agencje SEO w Polsce specjalizują się w AI Search?”, to obecność Twojej marki w odpowiedzi zależy od kilku czynników. Czy Twoje treści były w korpusie treningowym modelu? Czy pojawiasz się w kontekście cytowań w wiarygodnych źródłach? Czy inne modele (z dostępem do internetu) Cię „widzą”? To zupełnie inne zmienne niż profil linków i zagęszczenie słów kluczowych, którymi rządzi się klasyczne SEO.
To nie jest SEO. To oddzielna dyscyplina z własnymi metrykami – Citation Rate, Share of Voice i Mention Rate.
Zrozumienie tych mechanizmów ułatwia przewodnik po GEO – optymalizacji pod generatywne wyszukiwarki. Jeśli interesuje Cię konkretna strona operacyjna, czyli jak ChatGPT postrzega Twoją markę i jak to zmienić, wejdź na pozycjonowanie w ChatGPT.
Zanim zaczniesz planować, sprawdź swój punkt startowy. Darmowe narzędzie Widoczność marki w AI zada zapytanie o Twoją markę czterem silnikom AI. Pokaże Ci, jak jesteś postrzegany na tle kategorii – całkowicie bez ręcznego testowania.
Często zadawane pytania o ChatGPT
Czy ChatGPT ma dostęp do internetu?
Jaka jest data odcięcia modelu?
Czy rozmowy z ChatGPT są używane do trenowania modelu?
Jak ChatGPT wypada w porównaniu do Claude?
Źródła
- ChatGPT sets record for fastest-growing user base – analyst note – Reuters, 2 lutego 2023. Raport UBS: 100 mln aktywnych użytkowników w dwa miesiące, TikTok potrzebował 9 miesięcy, Instagram 2,5 roku.
- Attention Is All You Need – Vaswani i in., arXiv, czerwiec 2017. Praca wprowadzająca architekturę Transformer opartą na mechanizmie uwagi.
- GPT-5.6 Sol – OpenAI, dokumentacja API. Okno kontekstowe 1 050 000 tokenów i data odcięcia wiedzy 16 lutego 2026 roku.
- GPT-6 Astra – OpenAI, dokumentacja API. Najmocniejszy model OpenAI: okno 1,05 mln tokenów, do 128 tys. tokenów wyjścia, data odcięcia wiedzy 30 kwietnia 2026, cena 10/50 USD za milion tokenów.
- Changelog – OpenAI, dokumentacja API. Udostępnienie GPT-6 Astra w API 3 września 2026 roku.
- GPT-6 Sol – OpenAI, dokumentacja API. GPT-6 Sol (22 września 2026): okno 1,05 mln tokenów, data odcięcia 20 kwietnia 2026, 2/10 USD za milion tokenów.
- Model Release Notes – OpenAI Help Center. Modele w ChatGPT: GPT-5.6 Sol w planach płatnych od 9 lipca 2026 (bez planów Free i Go); GPT-6 Pro napędzany GPT-6 Astra w planach Pro, Business i Enterprise.
- ChatGPT finally offers $100/month Pro plan – TechCrunch, 9 kwietnia 2026. Plany Free, Go (8 USD), Plus (20 USD) oraz Pro za 100 i 200 USD miesięcznie.
- The new GPT-5.6 family: Luna, Terra, Sol – Simon Willison, 9 lipca 2026. Ogólna dostępność rodziny GPT-5.6 (Sol, Terra, Luna) od 9 lipca 2026.
- ChatGPT Plans Compared: Every Tier, August 2026 Edition – Digital Applied, 7 sierpnia 2026. Plany ChatGPT: Free na GPT-5.6 Luna, Plus z Sol, Terra i Luna, Pro od 100 USD z 5× lub 20× limitów Plus i oknem do 400 tys. tokenów, Business 20 USD rocznie (25 USD miesięcznie) od 2 użytkowników.
- OpenAI Launches ChatGPT Images 2.0 – MacRumors, 22 kwietnia 2026. Premiera modelu ChatGPT Images 2.0 dostępnego w ChatGPT, Codex i API.
- ChatGPT reaches 900M weekly active users – TechCrunch, 27 lutego 2026. OpenAI podaje 900 mln aktywnych użytkowników tygodniowo i 50 mln płacących subskrybentów.
- Traditional Search Forecast To Fall 25% By 2026: Gartner – MediaPost, luty 2024. Prognoza Gartnera o spadku wolumenu zapytań w tradycyjnych wyszukiwarkach o 25% na rzecz chatbotów AI.
- Italian court kills OpenAI’s €15M fine – and it wasn’t even close – PPC Land, 2026. Rzymski sąd 18 marca 2026 roku uchylił karę 15 mln euro nałożoną na OpenAI przez włoski Garante.