Spis treści
- Czym jest DeepSeek i skąd się wziął
- Jak działa DeepSeek – architektura Mixture of Experts
- Rodzina modeli DeepSeek – od V3 do V4
- Ile kosztuje DeepSeek – rewolucja cenowa
- Licencja MIT i modele open source – co to realnie daje firmom
- Bezpieczeństwo danych i cenzura – czego nie wolno pominąć
- DeepSeek a widoczność marki w AI
- Kiedy wybrać DeepSeek – i kiedy lepiej odpuścić
DeepSeek to chiński model językowy, który w styczniu 2025 roku zrobił coś, czego nie udało się żadnemu wcześniejszemu wyzwaniu wobec OpenAI – dorównał najlepszym modelom Zachodu przy kilkukrotnie niższych kosztach i udostępnił wagi za darmo. Efekt był na tyle silny, że wywołał gwałtowną przecenę spółek technologicznych i na stałe zmienił rozmowę o tym, ile naprawdę kosztuje budowa modelu klasy premium. Ten przewodnik wyjaśnia, jak działa DeepSeek, czym różnią się jego modele i co jego otwartość oznacza dla widoczności Twojej marki oraz dla bezpieczeństwa danych.
Czym jest DeepSeek i skąd się wziął
DeepSeek nie powstał w typowym laboratorium AI. Jego właścicielem jest High-Flyer – chiński fundusz hedgingowy z Hangzhou, który przez lata budował własne klastry obliczeniowe do handlu ilościowego. W kwietniu 2023 roku fundusz uruchomił laboratorium badawcze skupione na sztucznej inteligencji ogólnej, a w lipcu 2023 wydzielił z niego osobną firmę – DeepSeek. Kierujący całością Liang Wenfeng pozostaje jej głównym udziałowcem.
Przełom przyszedł w styczniu 2025 roku wraz z modelem DeepSeek-R1. Osiągał on wyniki zbliżone do ówczesnych flagowców OpenAI w zadaniach wymagających wnioskowania, ale został wytrenowany za ułamek ich budżetu. Komentatorzy nazwali ten moment „chwilą Sputnika” dla amerykańskiej branży AI – sygnałem, że przewaga oparta na dostępie do najdroższych chipów nie jest tak trwała, jak zakładano.
Jak działa DeepSeek – architektura Mixture of Experts
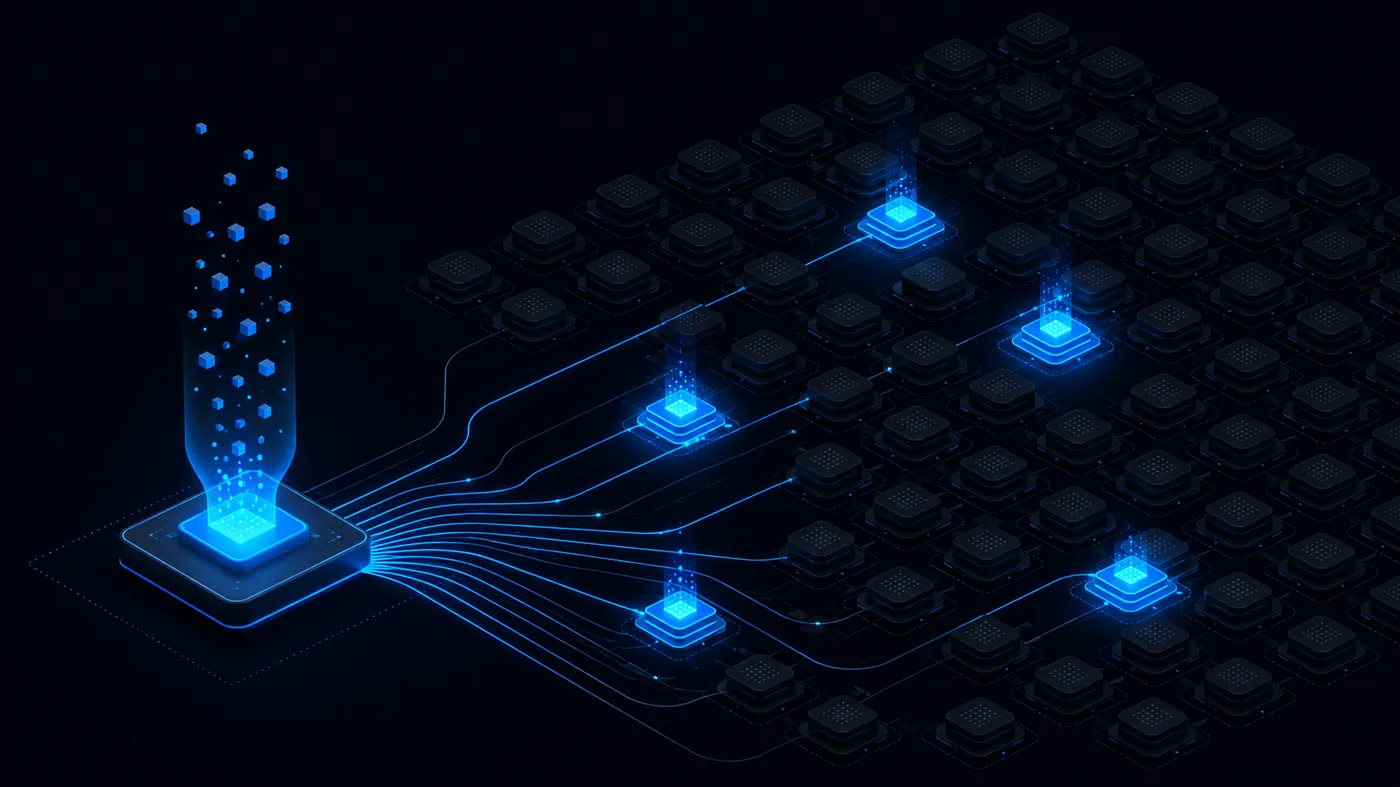
Sercem DeepSeeka jest architektura Mixture of Experts (MoE, mieszanka ekspertów). W klasycznym modelu każdy token przechodzi przez całą sieć. W modelu MoE sieć jest podzielona na wiele wyspecjalizowanych podsieci („ekspertów”), a dla każdego tokena aktywuje się tylko niewielka ich część. Dzięki temu model może mieć ogromną liczbę parametrów, ale w danym momencie „pracuje” tylko ich fragment.
To rozróżnienie – parametry całkowite kontra aktywne – jest kluczowe dla zrozumienia, dlaczego DeepSeek jest tak tani w działaniu. Flagowy V4-Pro ma 1,6 biliona parametrów całkowitych, ale tylko 49 miliardów aktywnych na token. Koszt obliczeniowy zależy głównie od tych aktywnych, a nie od całkowitej wielkości modelu.
DeepSeek dołożył do tego kilka autorskich optymalizacji:
- Multi-head Latent Attention (MLA) – kompresuje pamięć podręczną uwagi, dzięki czemu model obsługuje długi kontekst mniejszym kosztem pamięci.
- Predykcja wielu tokenów (multi-token prediction) – model uczy się przewidywać kilka kolejnych tokenów naraz, co przyspiesza generowanie.
- Rzadkie mechanizmy uwagi (sparse attention) – ograniczają liczbę porównań przy bardzo długich dokumentach.
Efekt praktyczny: według raportu technicznego pełny trening modelu V3 zajął 2,788 mln godzin pracy GPU H800, a firma osiągnęła to na słabszych chipach przeznaczonych na rynki objęte amerykańskimi ograniczeniami eksportowymi.
Rodzina modeli DeepSeek – od V3 do V4
DeepSeek rozwija dwie linie: modele ogólnego przeznaczenia (dawniej deepseek-chat) oraz modele wnioskujące (dawniej deepseek-reasoner). Poniższa tabela zestawia najważniejsze wydania.
| Model | Data | Parametry (aktywne) | Kontekst | Licencja |
|---|---|---|---|---|
| DeepSeek-V3 | grudzień 2024 | 671 mld (37 mld) | 128 tys. | MIT |
| DeepSeek-R1 | styczeń 2025 | ok. 671 mld (37 mld) | 128 tys. | MIT |
| DeepSeek-V3.2 | grudzień 2025 | – | 128 tys. | MIT |
| DeepSeek-V4-Flash | kwiecień 2026 | 284 mld (13 mld) | 1 mln | MIT |
| DeepSeek-V4-Pro | kwiecień 2026 | 1,6 bln (49 mld) | 1 mln | MIT |
| DeepSeek-V4.1-Flash | wrzesień 2026 | 552 mld (8 mld wejście / 16 mld wyjście) | 1 mln | MIT |
Aktualnie w API dostępne są dwa modele. V4.1-Flash (identyfikator deepseek-flash, od 10 września 2026 roku) to wariant wydajnościowy – szybki, tani, z natywną obsługą obrazów, do zadań o dużej skali. V4-Pro (wersja V4-Pro-0813, identyfikator deepseek-v4-pro) to duży model wnioskujący, przeznaczony do złożonego rozumowania, kodowania agentowego i analiz. Oba obsługują okno kontekstowe 1 miliona tokenów (V4.1-Flash generuje do 384 tys. tokenów odpowiedzi i domyślnie działa w trybie myślenia), co pozwala przetworzyć kilka obszernych raportów w jednej sesji. Starsze nazwy modeli deepseek-chat i deepseek-reasoner zostały wycofane 24 lipca 2026 roku, a zapytania do deepseek-v4-flash obsługuje już V4.1-Flash – DeepSeek utrzymuje szybkie tempo iteracji, więc przy wdrożeniach warto sprawdzać aktualny identyfikator modelu w dokumentacji. API DeepSeeka obsługuje też format API Anthropic, co ułatwia przepięcie istniejących integracji.
Ile kosztuje DeepSeek – rewolucja cenowa
To właśnie cena jest głównym argumentem DeepSeeka. Firma konsekwentnie schodzi poniżej stawek amerykańskich dostawców, często o rząd wielkości. Oficjalny cennik API (za 1 milion tokenów, stawki w godzinach szczytu) wygląda następująco:
| Model | Wejście (cache miss) | Wyjście |
|---|---|---|
| deepseek-flash (V4.1-Flash) | 0,30 USD | 1,20 USD |
| deepseek-v4-pro (V4-Pro-0813) | 1,32 USD | 3,96 USD |
Poza godzinami szczytu (w dni robocze szczyt to 01:00–04:00 i 06:00–10:00 UTC) wszystkie stawki są o połowę niższe. Dla porównania: najmocniejszy model OpenAI w API, GPT-6 Astra, kosztuje 10 USD za milion tokenów wejściowych i 50 USD za wyjściowe, a wydany 22 września 2026 roku GPT-6 Sol – 2 i 10 USD (tyle samo kosztuje nowszy GPT-6.1 Sol z 29 września). Oznacza to, że V4.1-Flash jest w warstwie wejściowej ok. 7 razy tańszy od GPT-6 Sol (poza szczytem – ok. 13 razy) i ponad 30 razy tańszy od GPT-6 Astra, a V4-Pro – ok. 1,5 raza tańszy od GPT-6 Sol. Przewaga cenowa nie jest już jednak bezwzględna: najmniejszy GPT-6 Luna (0,10 USD wejście, 0,50 USD wyjście) kosztuje mniej niż V4.1-Flash. Do tego dochodzi agresywny rabat za trafienie w pamięć podręczną (cache hit), który przy powtarzalnych promptach dodatkowo obniża rachunek. Dla firm budujących własne aplikacje AI, w których liczą się miliony zapytań miesięcznie, ta różnica przekłada się wprost na model biznesowy.
Licencja MIT i modele open source – co to realnie daje firmom
Od stycznia 2025 roku DeepSeek publikuje wagi swoich modeli na licencji MIT – jednej z najbardziej permisywnych licencji open source. W praktyce oznacza to, że możesz pobrać model z Hugging Face, dostroić go na własnych danych, uruchomić na swojej infrastrukturze i budować na nim komercyjne produkty bez opłat licencyjnych.
To zupełnie inna filozofia niż w przypadku ChatGPT czy Claude, gdzie masz dostęp wyłącznie do gotowego produktu przez API. Otwartość DeepSeeka daje trzy rzeczy, których modele zamknięte nie oferują:
- Suwerenność danych – uruchamiając model lokalnie, masz pewność, że żadne zapytanie nie opuszcza Twojej infrastruktury. To argument decydujący w branżach regulowanych.
- Brak limitów i uzależnienia od dostawcy – nie zależysz od cennika, limitów API ani decyzji o wycofaniu modelu.
- Możliwość dostrajania – model dostrojony na danych z konkretnej niszy działa w niej lepiej niż ogólny model komercyjny.
Ważne zastrzeżenie: publiczne są same wagi, a nie dane treningowe. Nie wiesz więc dokładnie, na czym model był uczony – co ma znaczenie przy ocenie jego wiedzy o Twojej marce i kategorii.
Bezpieczeństwo danych i cenzura – czego nie wolno pominąć
Tu zaczynają się kwestie, które dla firmy są równie ważne jak benchmarki. Korzystanie z oficjalnej aplikacji i API DeepSeeka oznacza, że dane trafiają na serwery w Chinach i podlegają tamtejszemu prawu, które daje władzom szerokie możliwości dostępu do danych. Dla informacji wrażliwych, danych osobowych klientów czy dokumentacji objętej RODO jest to ryzyko trudne do zaakceptowania. Z tego powodu DeepSeek został objęty ograniczeniami lub zakazami w części instytucji publicznych i firm na świecie.
Druga kwestia to cenzura. W tematach politycznie wrażliwych dla Chin model w oficjalnej wersji unika odpowiedzi lub powiela oficjalną narrację. Uruchomienie otwartych wag lokalnie usuwa część filtrów nakładanych po stronie usługi, ale ślady dostrajania pod chińskie regulacje pozostają w samym modelu.
Na to nakłada się szerszy kontekst rywalizacji. W lutym 2026 roku Anthropic publicznie zarzucił DeepSeekowi, Moonshot i MiniMax pozyskiwanie danych z modelu Claude metodą destylacji – trzy laboratoria miały użyć łącznie ok. 24 tys. fałszywych kont, a na DeepSeeka przypadło ponad 150 tys. wymian z modelem. Spór dobrze pokazuje, jak wysoka jest stawka w wyścigu o przewagę modeli.
Praktyczny wniosek dla firm: DeepSeek świetnie sprawdza się tam, gdzie liczą się koszt i kontrola nad wdrożeniem, ale wyłącznie w wariancie self-hosted, jeśli w grę wchodzą dane wrażliwe. Więcej o tym, jak podejść do tego tematu systemowo, piszemy w artykule o bezpieczeństwie danych w pracy z LLM.
DeepSeek a widoczność marki w AI
Z perspektywy GEO DeepSeek zachowuje się inaczej niż wyszukiwanie w ChatGPT czy Perplexity. Firma nie publikuje własnego bota indeksującego sieć, więc nie odblokujesz go w robots.txt, jak PerplexityBot czy GPTBot. Jego wiedza o Twojej marce pochodzi głównie z danych treningowych – zbiorów takich jak Common Crawl. Wyjątkiem jest tryb wyszukiwania w aplikacji i na chat.deepseek.com: po włączeniu przycisku „Search” asystent pobiera aktualne wyniki z sieci, więc dobrze zaindeksowane, cytowalne treści także tu mają znaczenie.
Ma to dwie konsekwencje dla strategii treści:
- Liczy się obecność w publicznych, dobrze ustrukturyzowanych źródłach, które trafiają do zbiorów treningowych – encyklopedie, branżowe serwisy, dokumentacja, treści cytowane przez innych. To praca długofalowa, bo wpływa na kolejne generacje modelu, a nie na odpowiedź „na dziś”.
- Wdrożenia klientów bywają zasilane RAG-iem – firmy uruchamiające DeepSeek lokalnie często podłączają go do własnej bazy wiedzy. Jeśli Twoje treści trafią do takiej bazy (np. jako źródło w narzędziu, z którego korzysta klient), model będzie je cytował niezależnie od danych treningowych.
Zanim zaczniesz optymalizować pod konkretny model, warto sprawdzić punkt wyjścia – czy i jak główne silniki AI mówią o Twojej marce. Pomaga w tym Widoczność marki w AI, który odpytuje kilka silników i pokazuje, jak wypadasz na tle kategorii.
Kiedy wybrać DeepSeek – i kiedy lepiej odpuścić
DeepSeek nie jest uniwersalną odpowiedzią, ale w kilku scenariuszach trudno o lepszy wybór. Poniższe kryteria pomagają zdecydować.
DeepSeek ma sens, jeśli:
- budujesz aplikację o dużej skali, w której koszt tokenów jest głównym ograniczeniem, a przetwarzane dane nie są wrażliwe;
- potrzebujesz pełnej kontroli i chcesz uruchomić model na własnej infrastrukturze, z możliwością dostrajania;
- eksperymentujesz i prototypujesz – niski koszt pozwala testować pomysły bez wysokich rachunków.
Lepiej rozważyć inny model, jeśli:
- przetwarzasz dane osobowe lub poufne i nie masz zasobów, by uruchomić model lokalnie w UE – wtedy bezpieczniejszy jest Claude w planie z brakiem retencji danych albo europejski model open source;
- zależy Ci na aktualnej wiedzy z sieci i cytowaniach – tu wygrywają silniki z RAG jak Perplexity;
- działasz w tematyce wrażliwej dla chińskiej cenzury, gdzie filtry modelu mogą zniekształcić odpowiedź.
DeepSeek najlepiej traktować jako element szerszej układanki, a nie jako zamiennik wszystkiego. Pełny obraz ekosystemu i kryteria doboru modelu do strategii znajdziesz w przewodniku po modelach językowych. Jeśli chcesz oprzeć decyzje na danych, a nie na domysłach, punktem wyjścia jest pozycjonowanie AI – metodyka, która mierzy widoczność marki we wszystkich głównych modelach jednocześnie.
Często zadawane pytania o DeepSeek
Czy DeepSeek jest darmowy?
Czy DeepSeek jest bezpieczny dla danych firmowych?
Czym różni się DeepSeek V4-Pro od V4.1-Flash?
Czy DeepSeek cenzuruje odpowiedzi?
Czy mogę uruchomić DeepSeek lokalnie?
Źródła
- DeepSeek – Wikipedia. Definicja firmy: siedziba w Hangzhou, właściciel High-Flyer, założyciel Liang Wenfeng.
- DeepSeek-R1 Release – DeepSeek, 20 stycznia 2025. Premiera R1 z wynikami porównywalnymi z OpenAI o1 i licencją MIT.
- DeepSeek sparks AI stock selloff; Nvidia posts record market-cap loss – Reuters (przedruk The Kathmandu Post), 28 stycznia 2025. Rekordowa jednodniowa utrata 593 mld USD wartości Nvidii i określenie „moment Sputnika”.
- DeepSeek-V3 Technical Report – DeepSeek-AI, grudzień 2024. Architektura MoE (671 mld parametrów, 37 mld aktywnych), MLA, predykcja wielu tokenów, kontekst 128 tys. oraz pełny trening w 2,788 mln godzin GPU H800 (ok. 5,576 mln USD).
- DeepSeek V4 Preview Release – DeepSeek, 24 kwietnia 2026. Parametry V4-Pro i V4-Flash, kontekst 1 mln tokenów oraz wycofanie nazw deepseek-chat i deepseek-reasoner.
- deepseek-ai/DeepSeek-V4-Pro – Hugging Face. Karta modelu z otwartymi wagami na licencji MIT.
- Models & Pricing – DeepSeek API Docs. Cennik API za milion tokenów dla deepseek-flash (V4.1-Flash, 1 mln kontekstu, 384 tys. wyjścia, vision) i deepseek-v4-pro (V4-Pro-0813), stawki poza szczytem (szczyt: 01–04 i 06–10 UTC pn–pt) o połowę niższe.
- DeepSeek-V4.1-Flash: Smarter, Faster, More Efficient – DeepSeek, 10 września 2026. Premiera V4.1-Flash (552 mld parametrów, 8 mld aktywnych przy przetwarzaniu wejścia i 16 mld przy generowaniu, natywna obsługa obrazów), identyfikator deepseek-flash i obniżka cen.
- deepseek-ai/DeepSeek-V4.1-Flash – Hugging Face. Karta modelu V4.1-Flash z otwartymi wagami na licencji MIT i kontekstem 1 mln tokenów.
- GPT-6 Sol – OpenAI API Docs. GPT-6 Sol (od 22 września 2026) – 2 USD za milion tokenów wejściowych i 10 USD za wyjściowe; GPT-6 Luna – 0,10 i 0,50 USD; okno 1,05 mln tokenów.
- GPT-6 Astra – OpenAI API Docs. Cena GPT-6 Astra – 10 USD za milion tokenów wejściowych i 50 USD za wyjściowe, okno 1,05 mln tokenów.
- Detecting and preventing distillation attacks – Anthropic, 23 lutego 2026. Zarzut kampanii destylacji Claude’a przez DeepSeek, Moonshot i MiniMax – łącznie ok. 24 tys. fałszywych kont i ponad 16 mln wymian, w tym ponad 150 tys. po stronie DeepSeeka.